 互联网新闻信息服务许可证号:51120180008互联网新闻信息服务许可证号:51120180008
金融投资网讯(记者 薛蕾)2月25日,在成都智算中心举办了DeepSeek大模型技术解读培训会,聚焦人工智能前沿技术,吸引了众多业内技术从业者和AI爱好者的积极参与。记者了解到,此次会议通过专家的深度解读,揭示了大模型赛道竞争与发展的核心逻辑,更传递了一系列关于AI未来发展的关键信号。
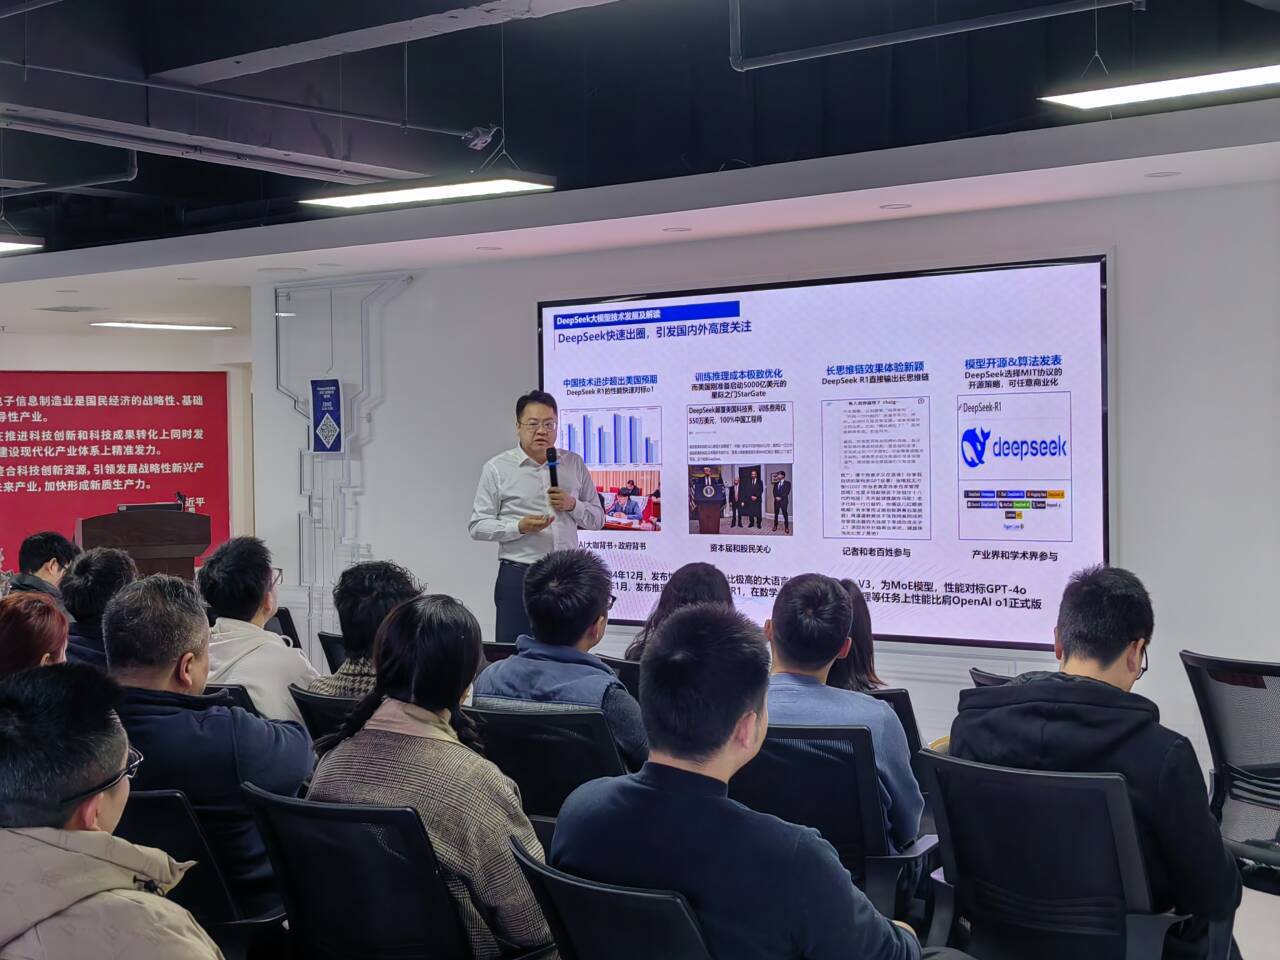
会议伊始,科大讯飞智算业务总经理刘啸对当前深度推理模型赛道的竞争格局进行了全面剖析。他以OpenAI o1、讯飞星火X1、DeepSeek-R1以及月之暗面的Kimi k1.5等深度推理模型为例,指出大模型技术已迈入“多维能力比拼”的新阶段。性能效率、场景适配以及工程落地成为衡量模型竞争力的重要维度。
DeepSeek大模型之所以能在激烈的竞争中脱颖而出,关键在于其三大技术革新:技术架构革新、工程优化突破以及训练方法创新。刘啸特别强调了DeepSeek R1在关键技术上的创新,并指出DeepSeek的出色表现已引起美国对中国人工智能发展的高度关注,这可能加剧对我国算力的严苛限制。因此,坚定地在国产化平台上发展通用人工智能已成为当务之急。
在人工智能产业发展趋势的分析中,科大讯飞智算总工许昀提出了一个核心观点:算力仍是大模型发展的必要基础设施,且其需求量将显著增加。这一观点从两个方面得到了佐证:
一方面,数据蒸馏技术的普及和应用虽然降低了训练高性能大模型对单一企业算力规模的依赖,但反而刺激了算力基础设施的需求。各家公司利用DeepSeek-R1等大型模型进行数据蒸馏以构建更适合自身业务场景的自有模型,这一过程本身就需要消耗大量的算力资源。此外,即使是作为“学生模型”的小型模型,其初始化训练和后续的蒸馏过程同样需要算力支持。
另一方面,随着数据蒸馏技术的成熟和应用门槛的降低,越来越多的中小型企业和研究机构将加入到大模型训练和蒸馏的行列中。这些新加入的生态参与者虽然规模相对较小,但数量庞大,他们对算力的需求汇聚起来将形成一个巨大的市场。这种专业化、精细化的模型训练需求将进一步推动算力资源的优化配置和高效利用,同时也为算力服务商带来了新的发展机遇。
此外,科大讯飞智算副总张骁提到,受到英伟达FP8技术优势以及美国出口管制政策的影响,国内市场对国产算力卡的需求日益迫切。为了满足国内大模型训练和推理的需求,发展自主可控的算力基础设施已成为必然趋势。

 官方微信
 企鹅号
 财富号
 一点号
 百家号
 网易号
 搜狐号
 头条号













